
国产大模型只差2.8%就追上Claude——但这2.8%可能要走很久
Mark投研备忘 · AI大模型商业观察系列 #3基于 OpenRouter 23天追踪数据 + SWE-bench / LMSYS Arena 权威评测如果你翻过墙、抢过GLM编程套餐、花15块钱买...
1464分!全球第五、中国第一!阿里通义千问3.5破局
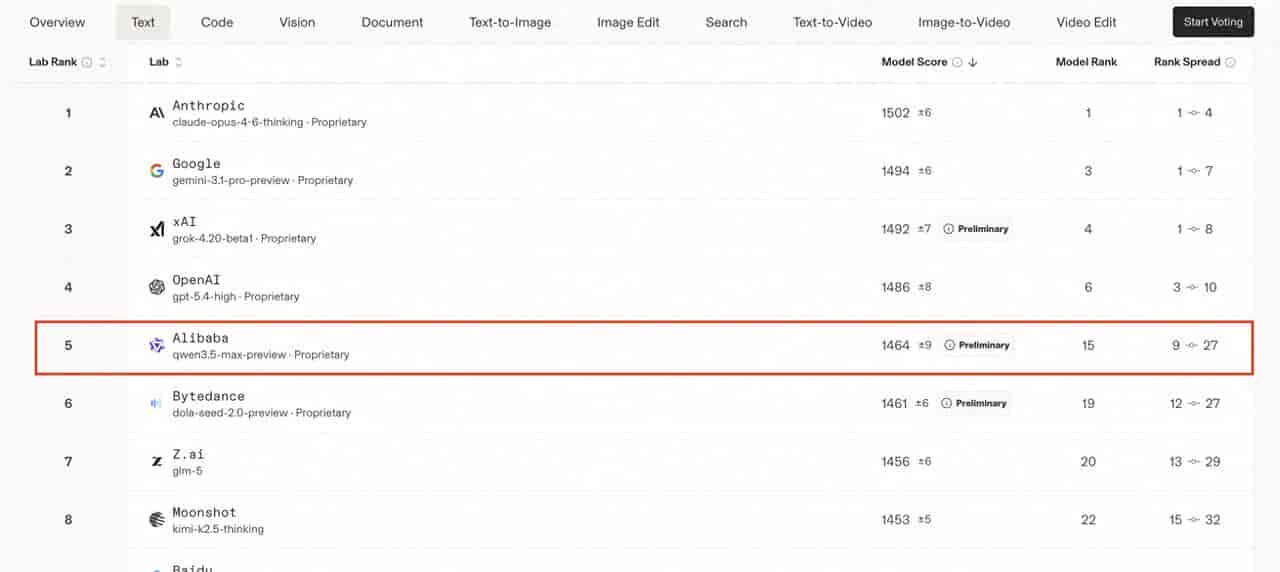
AI大模型赛道,向来是全球科技硬核竞争的核心战场。过去很长一段时间,头部席位始终被海外巨头牢牢把持,国产大模型大多徘徊在第二梯队,想要跻身全球前五,一度是遥不可及的目标。而就在近期,一条权威评测结果彻...
开源逆袭!小米MiMo-V2.5-Pro碾压Opus 4.5,MIT协议可商用
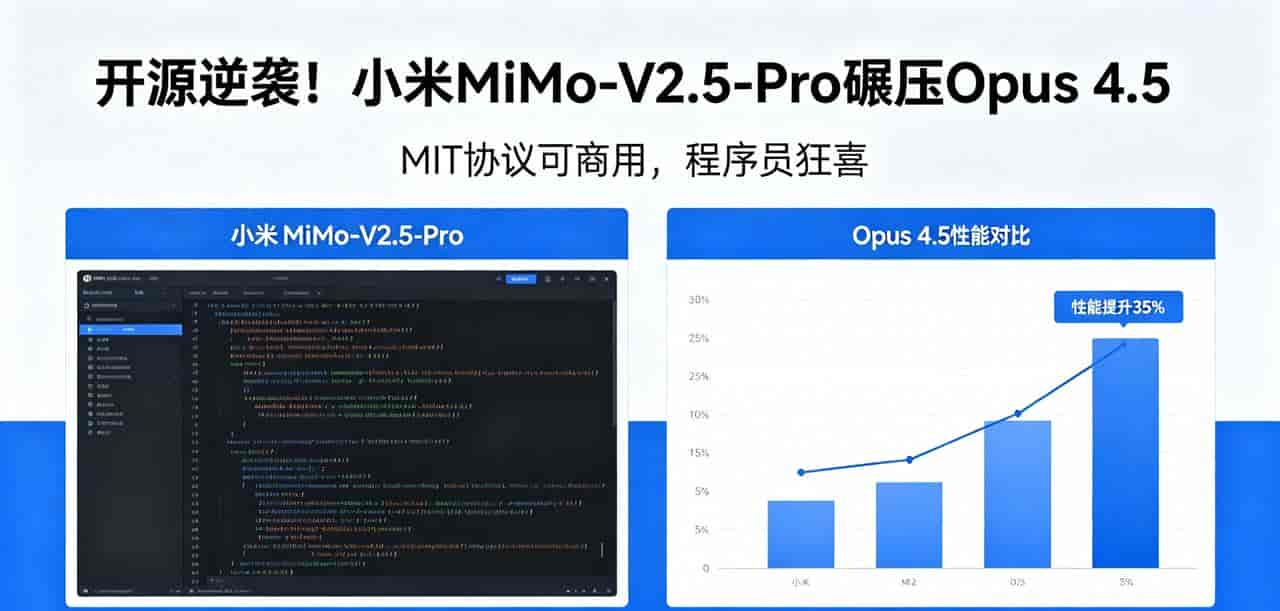
冷门榜单爆出大新闻,开源模型竟把闭源旗舰拉下马在AI大模型内卷到白热化的今天,所有人都默认一个共识:闭源模型垄断顶尖梯队,开源模型只能在中低端徘徊。尤其是Anthropic推出的Claude Opus...
斯坦福报告:中美AI差距只剩2.7%背后的真相
一、2.7%——一个重新定义格局的数字斯坦福HAI在4月13日发布了长达423页的《2026年人工智能指数报告》,其中一个数据引爆了整个科技圈:中美AI能力差距从2023年的300多分,缩小到了仅仅3...

中国 AI 正处于反超美国的前夜
作者丨王晓然编辑丨马晓宁2025 年下半年,中美 AI 圈中的讨论,有两个有趣的现象:一是,讨论的焦点不再是“中美技术究竟差几代”,而是开始认可中国 AI 势力崛起甚至即将迎来反超,列如以 Airbn...
AI三国志:2026年人工智能霸权战争全解析
2026年的AI战争,表面是模型性能之争,本质是基础设施主权之争。真正的护城河不是最机智的模型,而是谁控制了电力、芯片与分发渠道——以及谁定义了"AI应该是什么样的"。引言:一个对话框改变了世界202...

重磅!阿里Qwen3.5-Max-Preview盲测登顶全球权威榜单
3月20日,全球最权威的大模型盲测平台LMArena(原LMSYS Arena)发布最新榜单,一则重磅消息瞬间刷屏AI圈:阿里巴巴通义千问Qwen3.5-Max-Preview以1464分(部分榜单显...
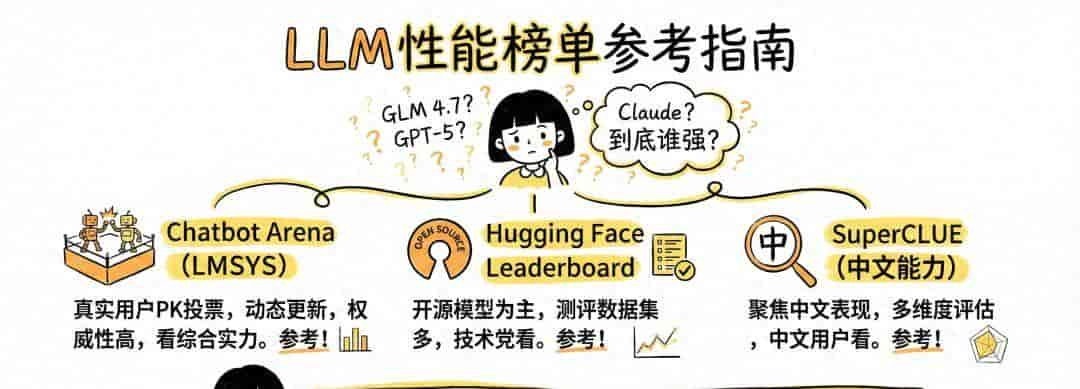
哪家 AI 更好用?2026最全 AI 大模型榜单,好不好用一目了然
目前各大模型厂商都在不断推出新模型,眼花缭乱。许多人想知道不同模型到底处于什么水平,列如最近 GLM 4.7 出来许多人很想知道水平怎样,往往得四处打听,可不同人给出的答案又不一样。那有没有一些榜单...

Gemini 3的意义:AI已超越“幻觉阶段”,逼近人类,“人机协作”将从“人对AI纠错”走向“人指导AI工作”
谷歌最新发布的Gemini 3模型正标志着人工智能领域的一个关键转折点。华尔街见闻此前提及,美东时间18日周二,谷歌正式发布备受期待的该司迄今最强劲人工智能(AI)模型Gemini 3,并于发布首日立...

山寨之王,联发科天玑系列真的能打了吗? 不看广告,看疗效
结论:开始追平,希望能稳定住3-5年答案是肯定的:从2024年的天玑9300开始,到2025年的天玑9400/9500,联发科不仅“能打”,而且在GPU能效、多核稳定性和AI算力上,常常把高通逼到墙角...